Widoczność w AI
Robots.txt i boty AI – co wpuścić, a co zablokować
w skrócie
- Robots.txt to prośba do botów, a nie zabezpieczenie – nie chroni danych i nie usuwa stron z Google.
- Boty AI dzielą się na trenujące modele (np. GPTBot, ClaudeBot) i pobierające strony na żywo (np. OAI-SearchBot, PerplexityBot).
- Chcesz, żeby AI polecało Twoją firmę? Wpuść boty wyszukujące, a o trenujących zdecyduj świadomie.
- Google-Extended nie wpływa na wyniki Google, a llms.txt to dodatek – Google go nie używa.
Robots.txt to plik tekstowy w głównym katalogu strony, w którym mówisz botom, które adresy mogą odwiedzać. Boty AI dzielą się na dwie grupy: trenujące modele (np. GPTBot) i pobierające strony na żywo do odpowiedzi (np. OAI-SearchBot). Jeśli chcesz, żeby AI polecało Twoją firmę, wpuść te drugie, a o pierwszych zdecyduj świadomie.
Spis treści 9
- Co to jest robots.txt i czego nie robi?
- Jakie są rodzaje botów AI?
- Jakie boty AI warto znać?
- Wpuścić czy zablokować boty AI?
- Jak ustawić robots.txt dla botów AI?
- Czy llms.txt zastępuje robots.txt?
- Jak sprawdzić, czy boty AI odwiedzają Twoją stronę?
- Jakie błędy w robots.txt zdarzają się najczęściej?
- Najczęstsze pytania
Co to jest robots.txt i czego nie robi?
Robots.txt leży zawsze pod tym samym adresem: twojafirma.pl/robots.txt. Składa się z grup zasad. Linia User-agent mówi, którego bota dotyczy grupa, a linie Disallow i Allow – których adresów nie wolno albo wolno mu pobierać. Na końcu zwykle jest adres mapy strony (Sitemap).
Bot szuka grupy ze swoją nazwą. Jeśli ją znajdzie, stosuje tylko ją i pomija zasady ogólne, przeznaczone dla wszystkich botów. Dzięki temu kilkoma linijkami zablokujesz wybrane boty, a resztę wpuścisz.
Równie ważne jest to, czego robots.txt nie robi:
- Nie chroni danych. To prośba, a nie zamek. Uczciwe boty jej słuchają, inne mogą ją zignorować. Sam plik jest publiczny, więc lista „ukrytych” katalogów to raczej wskazówka dla ciekawskich. Poufne pliki zabezpiecz hasłem.
- Nie usuwa strony z Google. Zablokowany adres może nadal pojawić się w wynikach – bez opisu – jeśli linkują do niego inne strony. Żeby podstrona nie trafiła do indeksu, użyj znacznika noindex.
- Nie działa wstecz. Blokada dotyczy kolejnych wizyt. Nie usuwa treści, które bot pobrał wcześniej, ani wiedzy, którą model już ma.
Jakie są rodzaje botów AI?
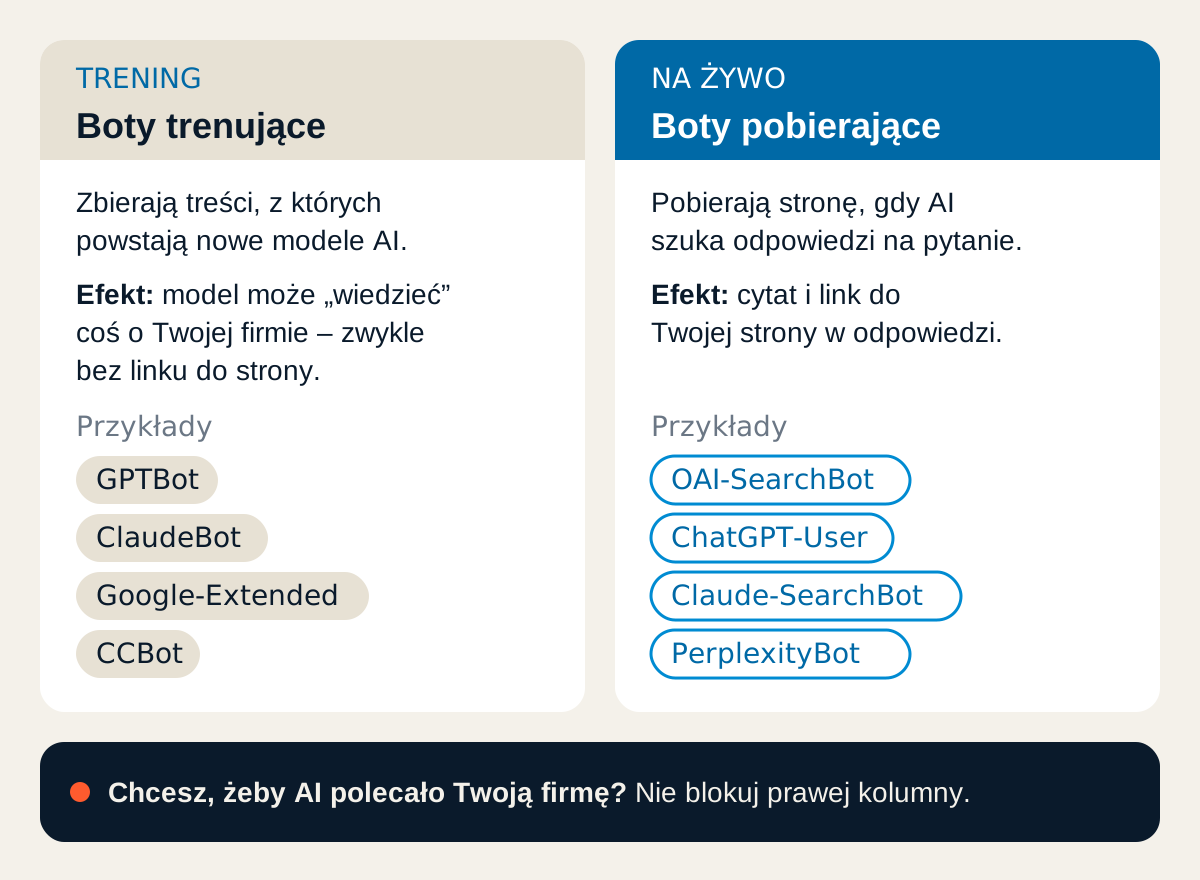
Boty firm od AI robią dwie różne rzeczy i to rozróżnienie jest ważniejsze niż ich nazwy.
Boty trenujące zbierają treści, z których powstają przyszłe wersje modeli językowych. Jeśli je wpuścisz, model może z czasem „wiedzieć” więcej o Twojej firmie i branży. Efekt jest pośredni i odłożony w czasie, a w odpowiedzi zwykle nie ma linku do Twojej strony.
Boty pobierające na żywo odwiedzają stronę, kiedy asystent AI szuka odpowiedzi na pytanie albo buduje własny indeks wyszukiwania. To dzięki nim ChatGPT, Claude czy Perplexity mogą zacytować Twoją stronę i podać do niej link.
W tej drugiej grupie jest jeszcze podgrupa: boty uruchamiane na prośbę użytkownika, np. gdy ktoś wklei link do czatu. OpenAI i Perplexity piszą w dokumentacji wprost, że zasady z robots.txt mogą ich nie obejmować, bo pobranie zleca człowiek, a nie automat.
Jakie boty AI warto znać?
Poniżej najważniejsze nazwy (user-agenty), które wpisuje się w robots.txt. Lista się zmienia – dostawcy dodają nowe boty i zmieniają ich zadania – więc przed edycją pliku sprawdź aktualną dokumentację każdego z nich.
| User-agent | Firma | Rodzaj | Do czego służy |
|---|---|---|---|
| GPTBot | OpenAI | trening | zbiera treści do trenowania modeli |
| OAI-SearchBot | OpenAI | wyszukiwanie | buduje indeks wyszukiwania w ChatGPT; po blokadzie strona nie pojawi się w odpowiedziach z wyszukiwania |
| ChatGPT-User | OpenAI | na prośbę użytkownika | pobiera stronę, gdy prosi o to użytkownik ChatGPT; robots.txt może go nie obejmować |
| Google-Extended | trening | to nie osobny bot, tylko token: decyduje, czy treści pobrane przez Google mogą trenować modele Gemini i zasilać odpowiedzi w aplikacjach Gemini | |
| ClaudeBot | Anthropic | trening | zbiera treści do trenowania modeli Claude |
| Claude-SearchBot | Anthropic | wyszukiwanie | indeksuje strony na potrzeby wyszukiwania w Claude |
| Claude-User | Anthropic | na prośbę użytkownika | pobiera stronę, gdy użytkownik Claude zadaje pytanie |
| PerplexityBot | Perplexity | wyszukiwanie | indeksuje strony do wyników Perplexity; według firmy nie służy do trenowania modeli |
| Perplexity-User | Perplexity | na prośbę użytkownika | pobiera stronę na prośbę użytkownika; według dokumentacji zwykle ignoruje robots.txt |
| CCBot | Common Crawl | trening (pośrednio) | buduje otwarte archiwum stron, z którego korzystają m.in. twórcy modeli AI |
Uwaga na Google-Extended. Według dokumentacji Google ten token nie wpływa na obecność strony w wyszukiwarce ani na jej pozycje. AI Overviews są częścią wyszukiwarki, więc sterujesz nimi tak jak zwykłymi wynikami: zasadami dla Googlebota i znacznikami nosnippet, max-snippet czy noindex. Zablokowanie Googlebota oznacza zniknięcie z całego Google.
Wpuścić czy zablokować boty AI?
To decyzja biznesowa, nie techniczna. Zacznij od pytania: czy chcesz, żeby klienci trafiali na Twoją firmę przez ChatGPT, Gemini i Perplexity?
Jeśli tak – a dla większości firm usługowych i sklepów odpowiedź brzmi „tak” – wpuść boty wyszukujące: OAI-SearchBot, Claude-SearchBot, PerplexityBot i oczywiście Googlebota. Bez nich asystent nie zacytuje Twojej strony, a polecając firmy, sięgnie po te, których strony mógł przeczytać.
Boty trenujące to trudniejszy wybór:
| Wpuszczasz boty trenujące | Blokujesz boty trenujące | |
|---|---|---|
| Co zyskujesz | przyszłe modele mogą lepiej znać Twoją markę, ofertę i branżę | Twoje teksty nie trafią do nowych zbiorów treningowych firm, które respektują robots.txt |
| Co tracisz | wpływ na to, jak model wykorzysta Twoje treści | szansę, że model „z pamięci” wspomni Twoją firmę |
| Dla kogo | firmy usługowe, sklepy, agencje – wszyscy, którym zależy na rozpoznawalności | wydawcy, autorzy płatnych treści, firmy, które zarabiają na unikalnej wiedzy |
Nasz robots.txt wpuszcza wszystkie boty, także trenujące. Chcemy, żeby modele znały ofertę Getso, więc nie mamy powodu ich zatrzymywać.
Jak ustawić robots.txt dla botów AI?
Najczęściej wybiera się jeden z trzech wariantów:
| Wariant | Co wpisujesz | Efekt |
|---|---|---|
| Wpuszczam wszystkich | jedna grupa: User-agent: * i Allow: / | boty wyszukujące i trenujące mogą czytać całą stronę |
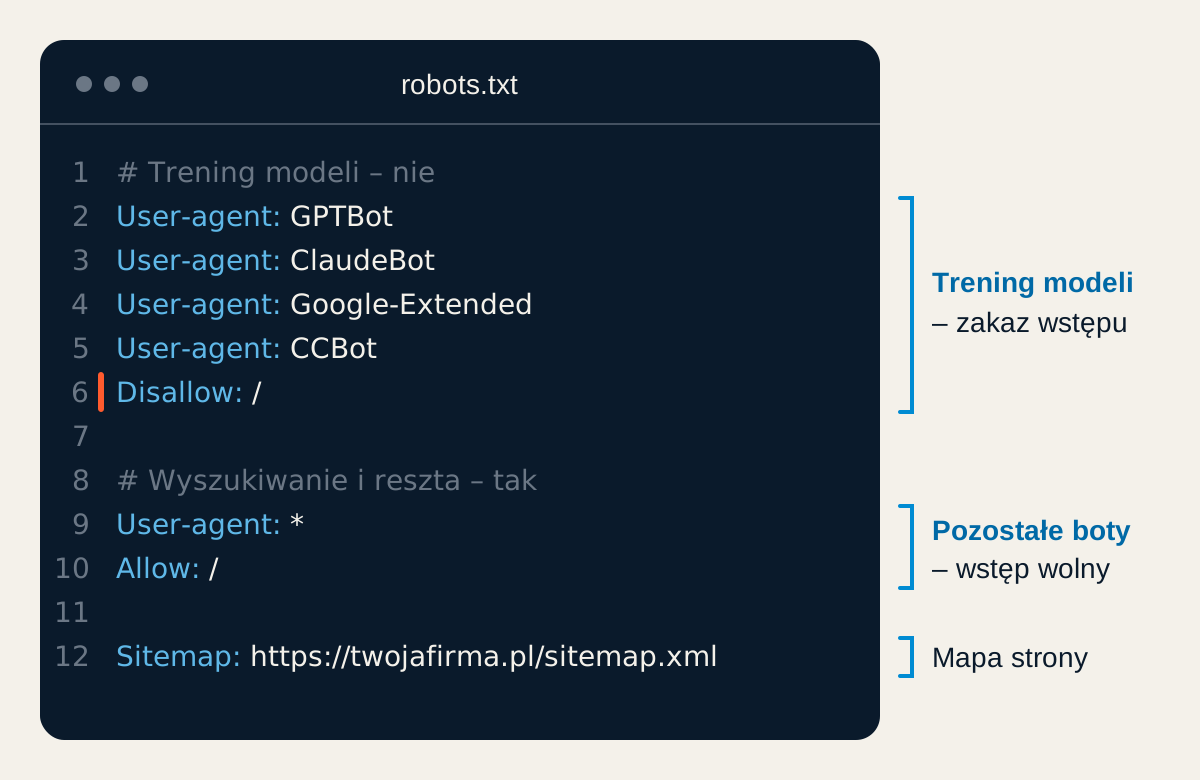
| Blokuję trening, wpuszczam wyszukiwanie | grupa GPTBot, ClaudeBot, Google-Extended i CCBot z Disallow: /, pod nią grupa ogólna z Allow: / | asystenci AI mogą cytować stronę, ale nie trafia ona do nowych zbiorów treningowych tych firm |
| Blokuję wszystkie boty AI | Disallow: / dla każdego bota AI z tabeli wyżej | asystenci przestają cytować stronę w odpowiedziach z wyszukiwania; boty na prośbę użytkownika mogą ją nadal pobierać, a Google działa bez zmian |
Tak wygląda drugi wariant w praktyce:
Kilka zasad przy edycji pliku:
- Plik musi leżeć w katalogu głównym domeny. Każda subdomena, np. sklep.twojafirma.pl, potrzebuje własnego.
- Wielkość liter w ścieżkach ma znaczenie. /Blog/ i /blog/ to dla bota dwa różne adresy.
- Zmiany nie działają od razu. Google zwykle przechowuje kopię pliku do 24 godzin, a OpenAI podaje, że zmiany dotyczące wyszukiwania w ChatGPT wchodzą w życie po około dobie.
- W WordPressie sprawdź, skąd pochodzi plik. Może go tworzyć sam system albo wtyczka SEO, a fizyczny plik na serwerze ma pierwszeństwo przed tym generowanym automatycznie.
Czy llms.txt zastępuje robots.txt?
Nie. Robots.txt mówi botom, czego nie wolno im pobierać. llms.txt to coś innego: plik w formacie Markdown z krótkim opisem firmy i listą najważniejszych podstron, przygotowany z myślą o modelach językowych. To nieoficjalna propozycja z 2024 roku, a nie standard.
Google pisze wprost, że do pojawienia się w AI Overviews nie są potrzebne żadne dodatkowe pliki dla AI, i z llms.txt nie korzysta. Część narzędzi i asystentów AI go czyta. Na getso.pl mamy llms.txt i dłuższy llms-full.txt, bo ich przygotowanie zajmuje chwilę.
Traktuj llms.txt jako dodatek. Nie pomoże, jeśli robots.txt blokuje boty albo strona nie odpowiada na pytania klientów. Co naprawdę wpływa na widoczność w AI, opisujemy we wpisie SEO, AEO i GEO – czym się różnią.
Jak sprawdzić, czy boty AI odwiedzają Twoją stronę?
- Zajrzyj do logów serwera. Każda wizyta bota zostawia wpis z jego nazwą – wyszukaj w nich GPTBot, OAI-SearchBot, ClaudeBot czy PerplexityBot. Dostęp do logów daje panel hostingu albo administrator serwera. Nazwę bota łatwo podrobić, dlatego dostawcy publikują listy swoich adresów IP.
- Sprawdź ruch z serwisów AI w GA4. Wejścia z chatgpt.com, perplexity.ai, gemini.google.com czy claude.ai widać w raporcie pozyskiwania ruchu jako źródła odesłań. To ludzie, którzy kliknęli link w odpowiedzi – dobry znak, że boty wyszukujące mają dostęp do strony.
- Otwórz raport robots.txt w Google Search Console. Pokazuje, jaką wersję pliku pobrał Google i czy znalazł w niej błędy.
- Sprawdź zaporę i CDN. Usługi takie jak Cloudflare mają osobne ustawienia blokowania botów AI, które działają niezależnie od robots.txt. Plik może wpuszczać boty, a zapora i tak je zatrzyma.
- Zadaj asystentom pytania, na które odpowiada Twoja strona. Sprawdź, czy pojawia się wśród źródeł w ChatGPT z wyszukiwaniem i w Perplexity.
Jakie błędy w robots.txt zdarzają się najczęściej?
- Blokada całej strony po migracji. Wersja testowa ma Disallow: / dla wszystkich botów, żeby nie trafiła do Google. Po przeniesieniu na docelową domenę ktoś zapomina usunąć tę linię i strona przestaje być odwiedzana przez Google i boty AI. Sprawdzaj robots.txt zaraz po każdym wdrożeniu.
- Blokowanie plików CSS i JavaScript. Stare poradniki zalecały blokowanie katalogów z zasobami strony. Bez nich Google nie widzi strony tak jak użytkownik i może ją gorzej zrozumieć.
- Mylenie robots.txt z noindex. Jeśli chcesz usunąć podstronę z Google, nie blokuj jej w robots.txt. Bot, który nie może wejść na stronę, nie zobaczy znacznika noindex, a adres może zostać w wynikach.
- Pomylone nazwy botów. Ktoś blokuje OAI-SearchBot, chcąc wyłączyć trening, albo Googlebota, chcąc wyłączyć AI Overviews – i traci widoczność w wyszukiwaniu ChatGPT albo w całym Google. Przed zmianą sprawdź w tabeli wyżej, za co odpowiada każdy bot.
Stan na: listopad 2026 – nazwy botów i zasady dostawców się zmieniają, sprawdź ich dokumentację.
Najczęstsze pytania
Czy zablokowanie GPTBot usunie moją firmę z ChatGPT?
Nie. GPTBot zbiera treści do trenowania przyszłych modeli. O tym, czy Twoja strona pojawia się w odpowiedziach ChatGPT z wyszukiwania, decyduje OAI-SearchBot. Blokada GPTBot nie usuwa też tego, co model już wie o Twojej firmie z innych źródeł.
Czy Google-Extended wyłącza AI Overviews?
Nie. Według dokumentacji Google token Google-Extended dotyczy trenowania modeli Gemini i odpowiedzi w aplikacjach Gemini, a nie wyszukiwarki. AI Overviews są częścią wyszukiwarki Google – ograniczysz je znacznikami nosnippet, max-snippet lub noindex, ale te działają też na zwykłe wyniki.
Gdzie znajdę plik robots.txt na mojej stronie?
Wpisz w przeglądarce adres domeny z dopiskiem /robots.txt, np. twojafirma.pl/robots.txt. Jeśli widzisz błąd 404, pliku nie ma, a boty traktują to jak zgodę na pobieranie całej strony. W WordPressie plik często tworzy sam system albo wtyczka SEO.
Czy robots.txt ochroni moje treści przed AI?
Tylko przed botami, które go przestrzegają. Plik nie zatrzyma botów, które go ignorują, a pobrania na prośbę użytkownika mogą go omijać. Jeśli treści mają być naprawdę chronione, potrzebujesz logowania albo blokady na poziomie serwera lub CDN.